
요구사항, 시안, 테스트 케이스를 에이전트에게 넘겼더니 150줄이 나왔습니다
앞 단계에서 만든 요구사항, 스토리보드, 시안, 테스트 케이스를 Claude Code에 넘겨 진행 표시 기능을 구현했습니다. 이미 있는 코드를 다시 쓰게 만든 과정과, 서버 렌더링과 브라우저 저장소가 부딪힌 지점을 정리했습니다.
기획부터 검증까지, AI와 넓힌 프론트엔드 개발자의 일· 5 / 6펼치기접기
앞의 네 편에서 진행 표시 기능의 요구사항, 스토리보드, 디자인 시안, 테스트 케이스를 만들었습니다. 이번에는 그걸 모두 Claude Code에 넘겨 구현했습니다. 결과는 파일 7개, 156줄 추가였고, 그중 새 파일은 두 개였습니다.
이 글에서는 앞 단계의 산출물이 구현에서 실제로 어떤 역할을 했는지, 그리고 그 산출물로도 막지 못한 문제가 무엇이었는지 정리합니다. 구현은 블로그와 분리된 작업 공간에서 했고, 블로그에는 반영하지 않았습니다.
개발은 이 시리즈에서 유일하게 제 전문 분야입니다. 그래서 앞 단계와 달리, 에이전트가 낸 결과를 판단하는 사람도 저였습니다.
1. 산출물은 질문을 줄여 줬습니다
에이전트에게 넘긴 건 1편의 요구사항과 스토리보드, 2편의 시안 HTML, 4편의 테스트 케이스 표였습니다. 구현하는 동안 "읽음 기준은 무엇으로 할까요"처럼 다시 정해야 하는 질문이 거의 없었습니다. 이미 문서에 답이 있었기 때문입니다.
특히 "하지 않는 것" 목록이 효과가 있었습니다. 서버 저장이나 기기 간 동기화를 제안하지 않았고, 로그인과 엮으려 하지도 않았습니다. 요구사항에 적지 않았다면 Supabase 테이블부터 만들자고 했을지도 모릅니다.
2. 이미 있는 코드를 먼저 찾게 했습니다
에이전트와 일하면서 자주 겪는 문제는, 이미 있는 것을 새로 만드는 일입니다. 그래서 구현 전에 비슷한 코드를 먼저 찾아보게 했습니다. 찾은 것은 세 가지였습니다.
- 에디터 임시 저장에 쓰는
src/store/draft.ts. Zustand의persist로 localStorage에 저장하는 패턴이 이미 있었습니다. - 시리즈 이전, 다음 글을 찾는
src/lib/series.ts의prevNext함수 - 블로그 전체에서 쓰는 lucide 아이콘과 브루탈 테두리 토큰
읽기 기록 저장소는 draft.ts와 같은 모양으로 만들어졌습니다.
export const useRead = create<ReadStore>()(
  persist(
    (set) => ({
      read: [],
      mark: (slug) => set((s) => (s.read.includes(slug) ? s : { read: [...s.read, slug] })),
    }),
    { name: "blog-read", skipHydration: true },
  ),
);
진행률을 계산하는 함수는 처음에 이 저장소 파일 안에 만들어졌습니다. 그런데 src/lib/series.ts에 시리즈 관련 순수 함수가 이미 모여 있다는 걸 보고, 그쪽으로 옮겼습니다. 테스트도 기존 lib.test.ts에 붙였습니다.
export function seriesProgress(slugs: string[], read: string[]) {
  const done = slugs.filter((s) => read.includes(s)).length;
  return { done, total: slugs.length, next: slugs.find((s) => !read.includes(s)) ?? null };
}
함수 하나 옮긴 것뿐이지만, 이런 일이 쌓이면 코드베이스가 같은 사람이 짠 것처럼 보이느냐가 갈립니다.
3. 서버 렌더링과 브라우저 저장소가 부딪혔습니다
문서에는 "서버 렌더링 결과에는 진행 정보가 없다, 브라우저에서 기록을 읽은 뒤 채운다"라고 한 줄 적혀 있었습니다. 구현에서 가장 손이 많이 간 곳이 바로 이 한 줄이었습니다.
Zustand의 persist는 기본적으로 저장소를 만들 때 localStorage를 바로 읽어 옵니다. 그러면 서버는 "0편 읽음"으로, 브라우저는 "2편 읽음"으로 첫 화면을 그리게 되고, 하이드레이션 결과가 어긋납니다. 그래서 skipHydration: true로 자동 복원을 끄고, 컴포넌트가 마운트된 뒤에 직접 복원하게 했습니다.
function useReadHydrated() {
  const [ready, setReady] = useState(false);
  useEffect(() => {
    Promise.resolve(useRead.persist.rehydrate()).then(() => setReady(true), () => {});
  }, []);
  return ready;
}
복원하기 전에는 진행 표시 대신 같은 높이의 빈 자리를 둡니다. 그렇지 않으면 기록을 읽어 온 순간 목록 전체가 아래로 밀립니다. 시리즈 페이지는 정적으로 만들어 두는 페이지라, 진행 표시처럼 사람마다 다른 정보는 이렇게 브라우저에서 따로 채워야 했습니다.
4. 읽음은 본문 끝이 보일 때 기록합니다
1편에서 정한 읽음 기준은 "본문 끝이 화면에 들어오면"이었습니다. 글 아래 이전, 다음 글 내비게이션 바로 위에 보이지 않는 요소를 두고, IntersectionObserver로 그 요소가 화면에 들어오는 순간을 잡았습니다.
const io = new IntersectionObserver(([e]) => {
  if (!e.isIntersecting) return;
  io.disconnect();
  Promise.resolve(useRead.persist.rehydrate()).then(() => useRead.getState().mark(slug), () => {});
});
한 번 기록하면 바로 관찰을 끊습니다. 스크롤할 때마다 저장소에 쓸 이유가 없기 때문입니다.
5. 결과 화면은 시안과 거의 같았습니다
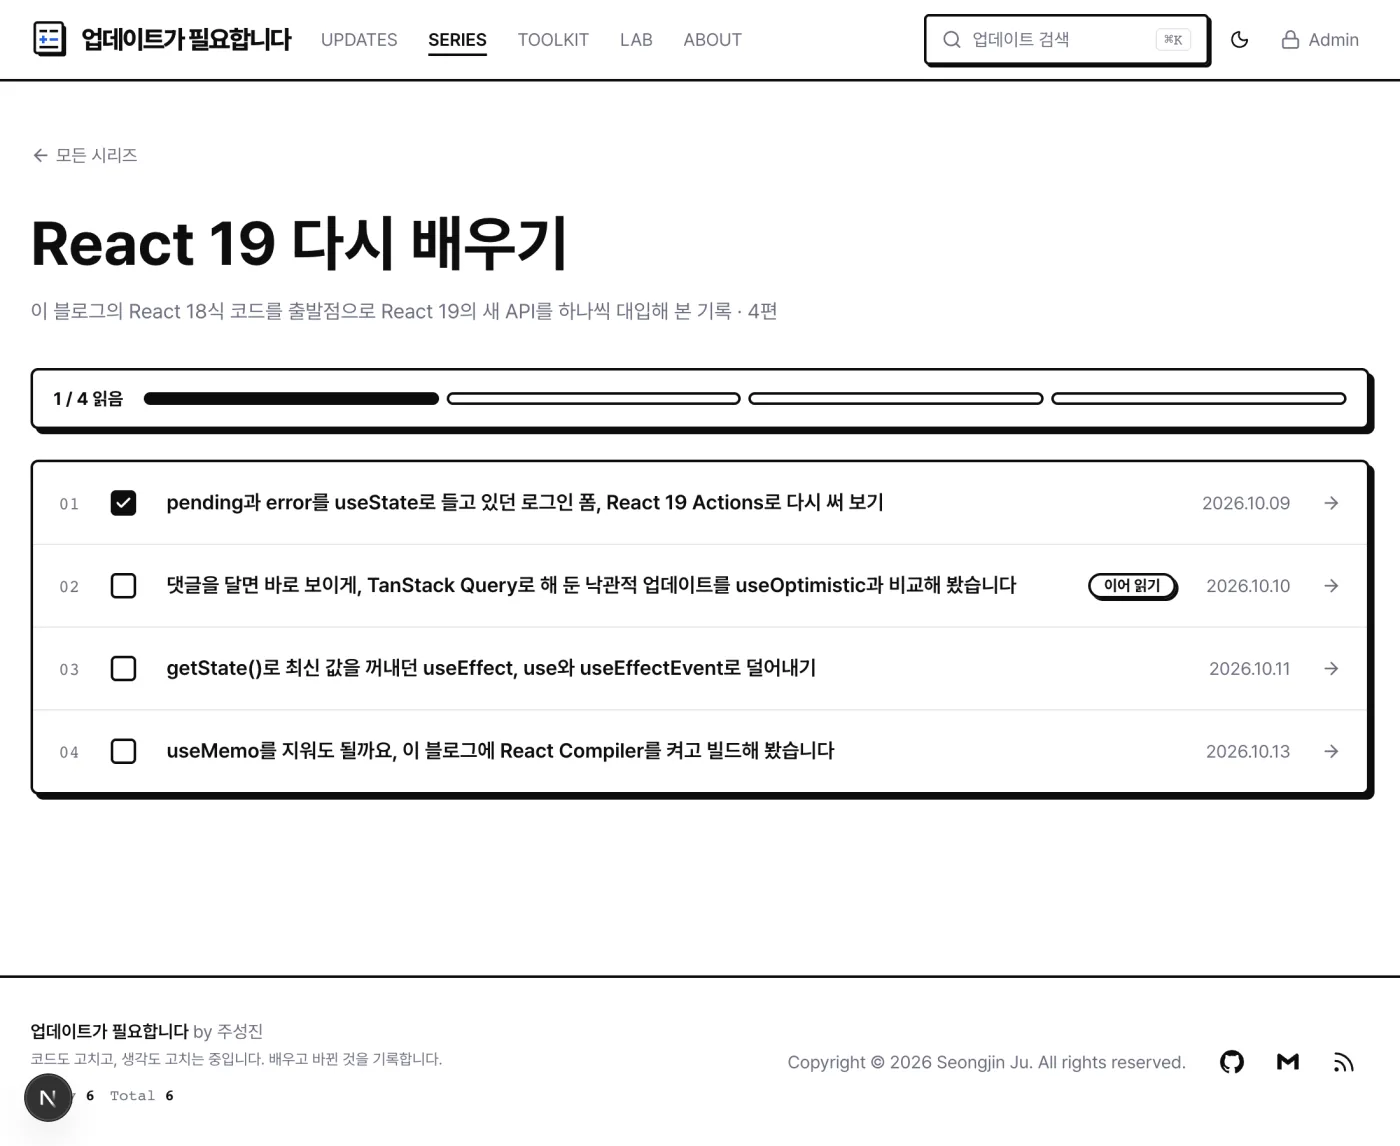
구현한 시리즈 페이지입니다. 1편을 끝까지 읽은 상태라 첫 칸이 채워져 있고, 2편에 "이어 읽기"가 붙어 있습니다.
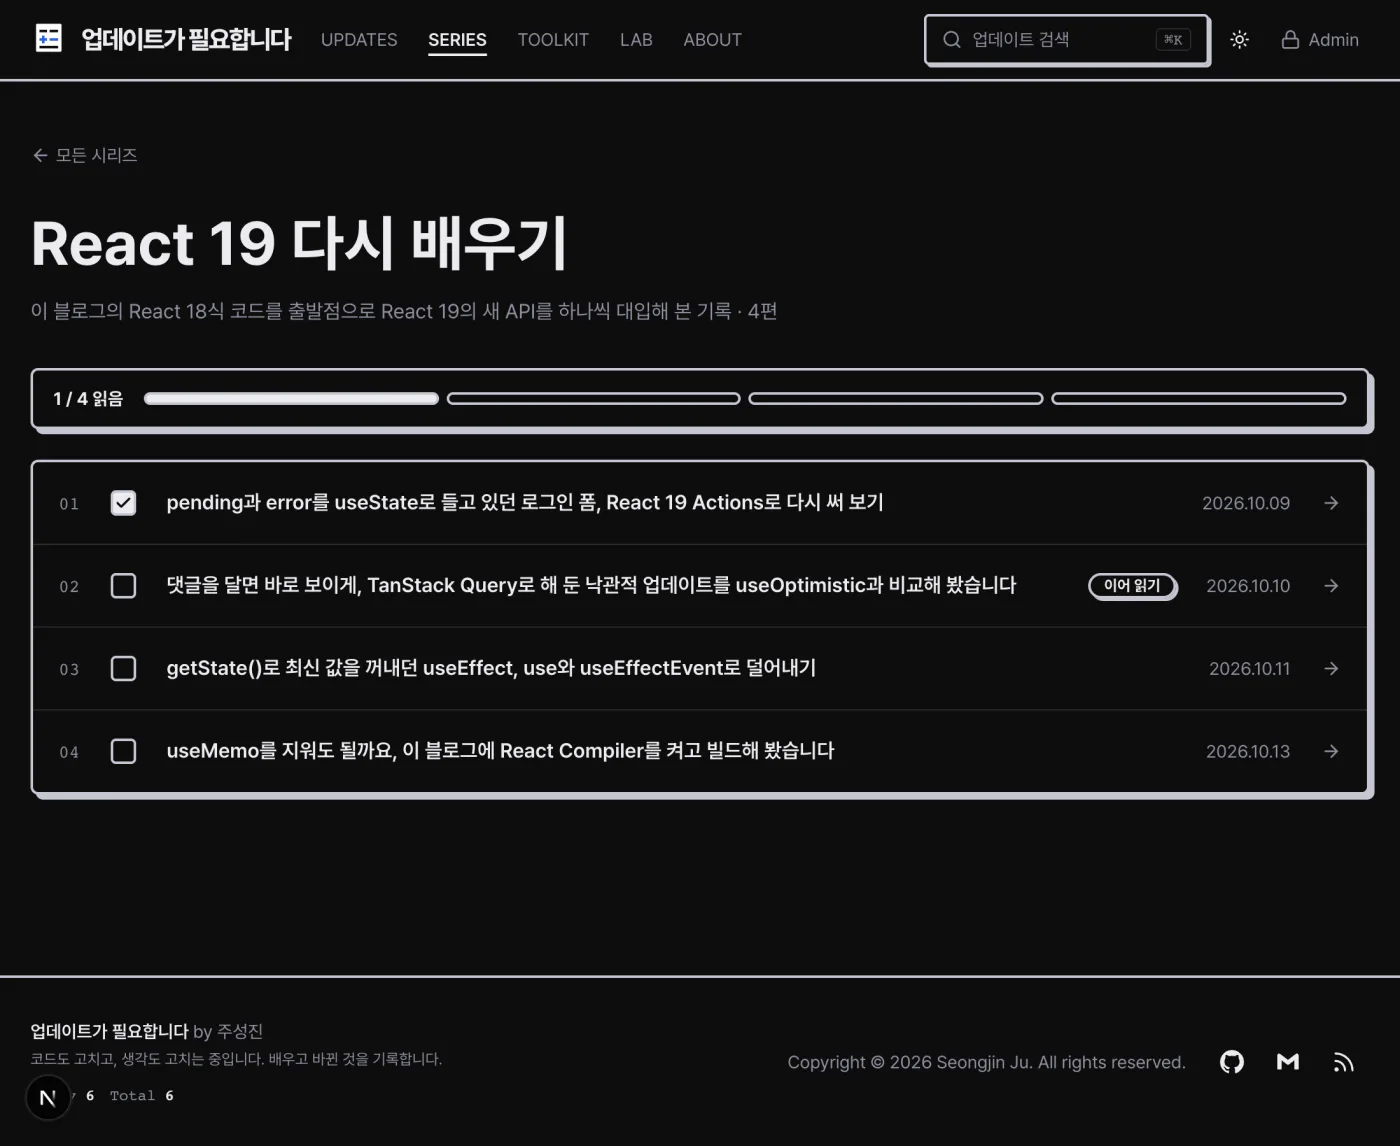
다크 모드에서도 블로그 토큰을 그대로 쓰기 때문에 따로 손볼 곳이 없었습니다.
글 안의 시리즈 상자에도 몇 편 읽었는지와 글마다 읽음 표시가 붙습니다.
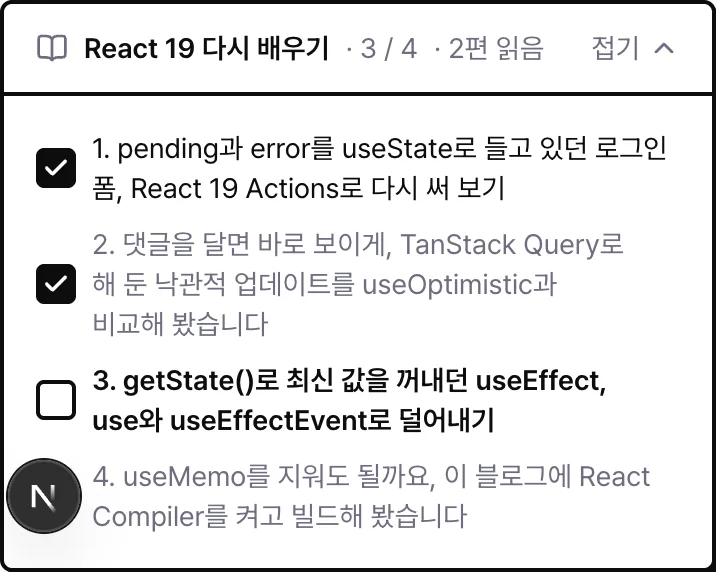
시안과 다른 점은 두 가지입니다. 2편 글에서 적었듯이 읽은 글 제목을 흐리게 하지 않았습니다. 그리고 "이어 읽기"는 하나라도 읽은 뒤에만 붙습니다. 1편 스토리보드에는 기록이 없으면 1편에 붙인다고 적었는데, 아직 시작하지도 않은 사람에게 "이어" 읽으라는 말이 어색했습니다. 둘 다 구현하면서 바꾼 결정이고, 4편의 테스트 케이스 표에도 반영했습니다.
마치며
산출물을 미리 만들어 둔 덕분에 구현 중 질문은 확실히 줄었습니다. 하지만 가장 오래 걸린 건 문서에 한 줄로 적힌 하이드레이션 문제였습니다. 문서는 무엇을 해야 하는지는 알려 줬지만, 어떻게 해야 하는지까지는 알려 주지 못했습니다.
타입 검사와 단위 테스트는 통과했지만, 이것만으로 다 됐다고 말하기는 이릅니다. 다음 글에서는 이 기능을 브라우저에서 직접 검증하면서 찾은 문제 두 가지를 정리합니다.
Comments (0)